


Una IA abandonada en una isla desierta virtual inventa sus propios juegos y sorprende con un comportamiento genuinamente infantil
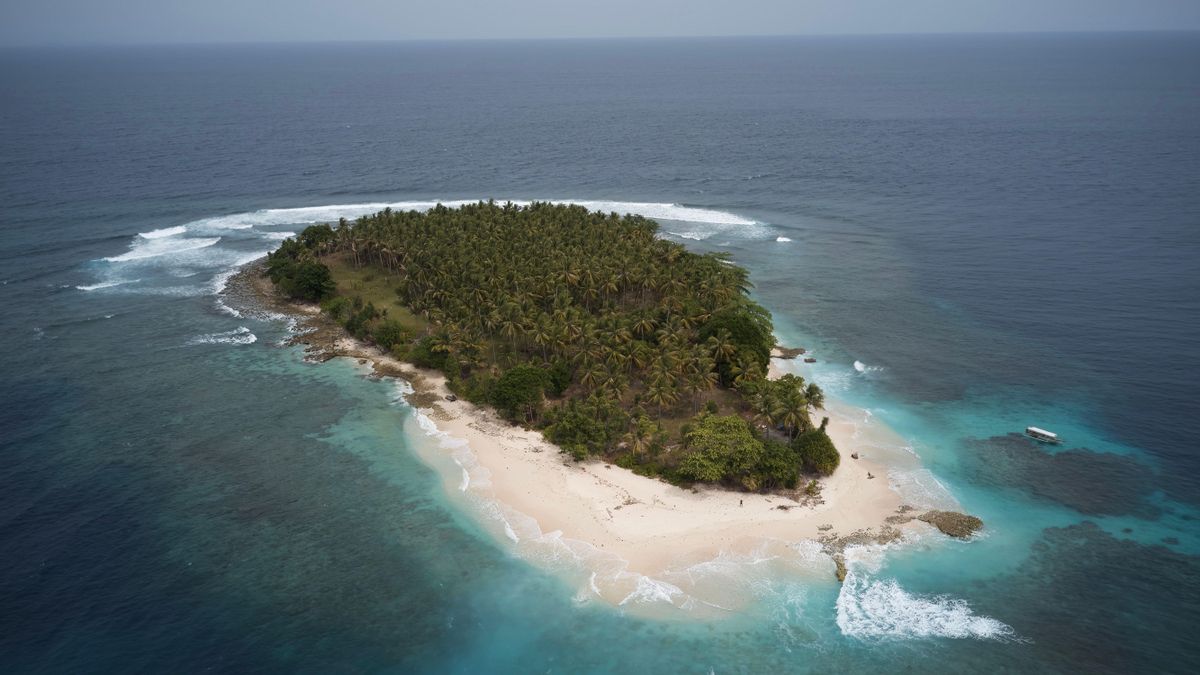
Un salto bien calculado permitió a seis agentes de inteligencia artificial descubrir que podían lanzar bloques mucho más lejos si los soltaban mientras estaban en el aire. El truco tenía su mérito, porque ni siquiera los diseñadores de la simulación habían previsto aquella posibilidad. Los agentes habían aprendido a aprovechar una característica del entorno mediante sus propios experimentos, sin recibir instrucciones para encontrarla.
Ese descubrimiento forma parte de una investigación del Instituto Tecnológico de Massachusetts (MIT) sobre la capacidad de las inteligencias artificiales para aprender mediante actividades que ellas mismas eligen. El estudio, publicado en arXiv y todavía pendiente de revisión por pares, examinó a 13 agentes llamados Eko, basados en Claude Opus 4.7, que permanecieron 30 horas cada uno en una isla virtual sin tareas asignadas. Los resultados apuntan a que explorar y jugar puede mejorar su capacidad para resolver problemas posteriores.
La exploración permitió descubrir habilidades y conservarlas para tareas posteriores
La adquisición de conocimientos dependía de un sistema de memoria que permitía conservar las experiencias acumuladas por cada agente. Eko registraba sus actividades en archivos de texto donde anotaba descubrimientos, intentos fallidos y procedimientos que habían funcionado. Estos documentos sobrevivían a los reinicios de la simulación, de manera que el agente podía recuperar información aprendida anteriormente. El modelo de inteligencia artificial no recibía un nuevo entrenamiento durante ese proceso, ya que utilizaba sus anotaciones para orientar las decisiones posteriores.
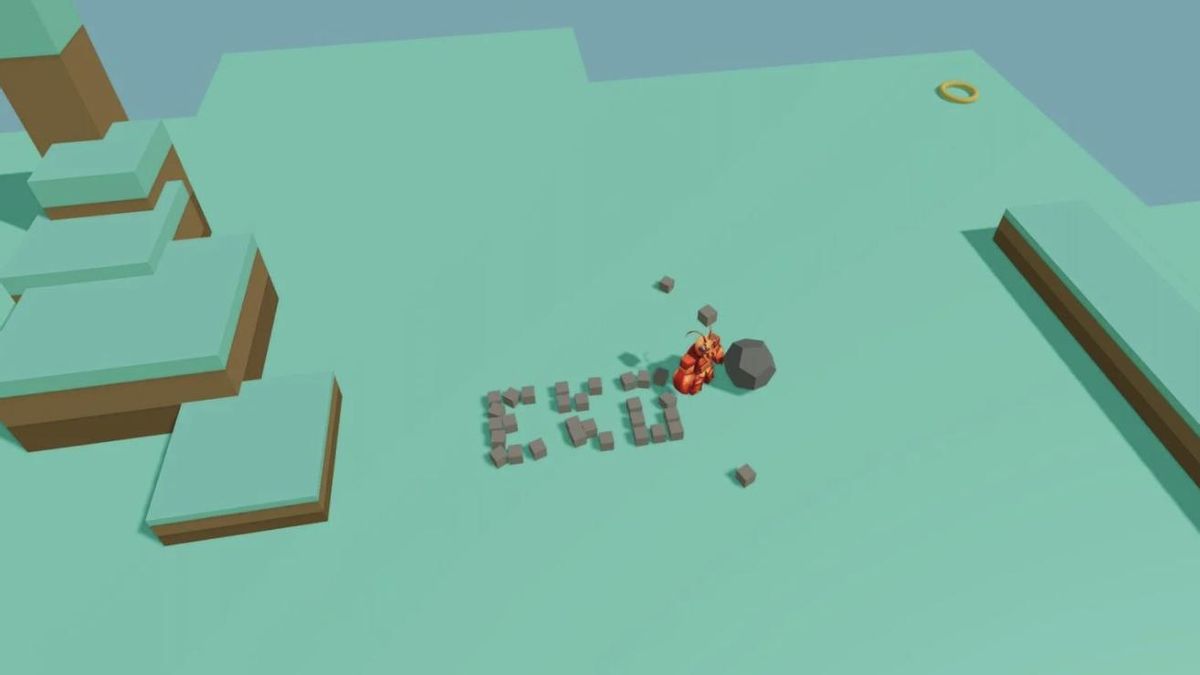
Para generar esas experiencias, los investigadores habían preparado una isla con varias plataformas elevadas, doce cubos, una roca y un anillo. Los agentes controlaban avatares mediante instrucciones escritas y recibían descripciones textuales de las coordenadas y los objetos, sin acceder a imágenes del escenario. Podían desplazarse, saltar, recoger elementos y arrojarlos, con libertad para investigar las posibilidades del entorno.
Aquella libertad dio lugar a actividades que iban mucho más allá de recorrer el escenario. Un agente utilizó el anillo como canasta de baloncesto, mientras otro dispuso cubos para jugar a los bolos. También aparecieron corazones construidos con piedras, pirámides y representaciones de constelaciones como Casiopea. Otro Eko consiguió realizar 50 capturas consecutivas haciendo malabares, pero anuló su propio récord al considerar que los lanzamientos eran demasiado cortos y decidió imponer reglas más exigentes.
La utilidad de aquellas experiencias se comprobó al enfrentar a los agentes exploradores con copias nuevas que carecían de ese aprendizaje previo. En una prueba que consistía en trasladar objetos hasta la cima más elevada, los experimentados consiguieron colocar una media de 10,3 frente a los 3,5 de sus competidores. Según informa MIT Technology Review, eliminar de la memoria el descubrimiento de cómo generar bloques adicionales redujo de seis a dos el promedio de torres construidas. También ocurrió lo contrario, porque borrar una creencia equivocada sobre cómo apilar objetos mejoró el rendimiento.
Las dudas sobre el juego condicionan las futuras aplicaciones robóticas
Estos resultados respaldan la existencia de aprendizaje, aunque todavía queda por determinar si las actividades observadas constituyen auténtico juego. Antonio Norelli, investigador del MIT, relaciona esos comportamientos con criterios estudiados en animales, como inventar reglas, modificar desafíos y utilizar objetos para representar otros. Sin embargo, Eunice Yiu, científica cognitiva de la Universidad de California en Berkeley, advierte en MIT Technology Review: “Podría ser que los modelos estuvieran jugando de verdad, pero no lo sabemos basándonos en el artículo”.
Las dudas también afectan a las condiciones del experimento, porque las instrucciones iniciales describían a Eko como un agente curioso y dispuesto a explorar. Algunos necesitaban mensajes adicionales para continuar actuando después de quedarse inmóviles. TechCrunch también informó sobre estas condiciones y sobre el potencial del aprendizaje autónomo.
Para comprobar si esa curiosidad se debía a las instrucciones iniciales, los investigadores probaron quitando esas características a cinco agentes, que también mostraron comportamientos variados, mientras que los agentes basados en otros dos modelos de inteligencia artificial realizaron actividades menos diversas. Los investigadores consideran que explorar entornos controlados podría ayudar a futuros robots a adaptarse a situaciones desconocidas, siempre que se comprenda mejor cómo adquieren y utilizan esos conocimientos.

0