


Xavier Nueno, escritor: “Detrás de las grandes tecnológicas hay una cultura de saqueo y rapiña”
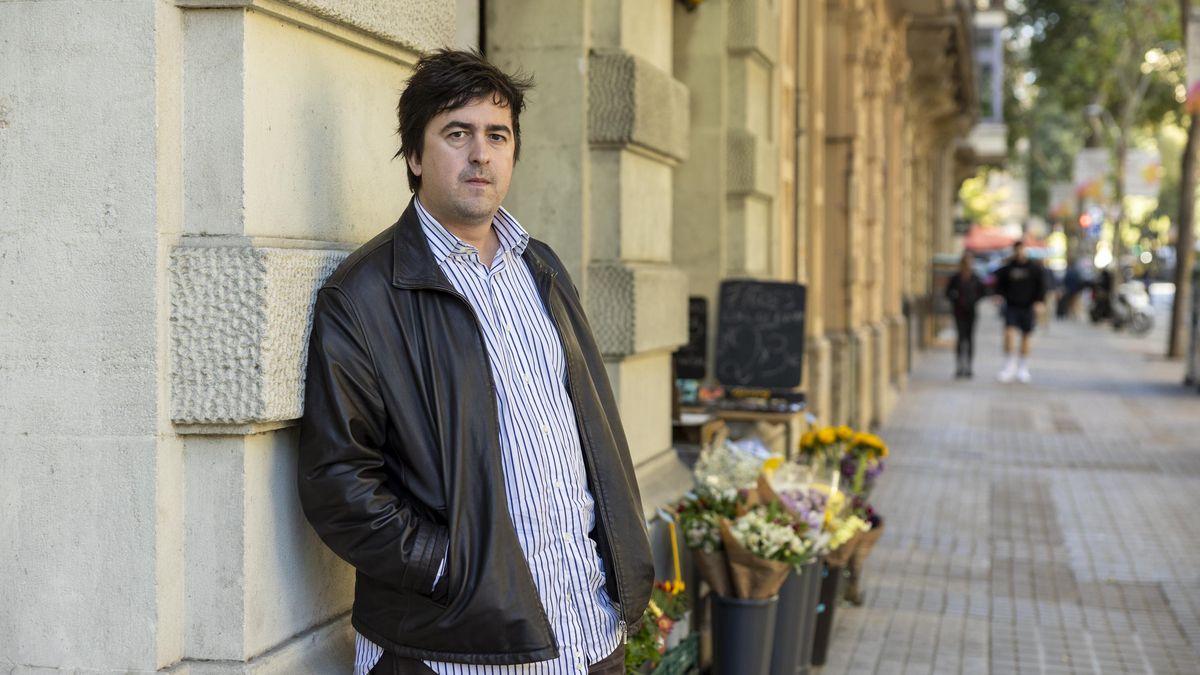
Como un espigador que recoge el trigo olvidado en un campo tras la siega, Xavier Nueno (Barcelona, 1990) ha buceado en archivos de los últimos 150 años para lanzar una advertencia: la privatización del conocimiento está alcanzando un peligroso grado de no retorno con la generalización de la inteligencia artificial, que requiere de un urgente control público.
El escritor ha plasmado esta tesis en La Revuelta de los copistas (Anagrama), una obra valiente y extraordinariamente bien documentada que le ha valido el premio Anagrama de ensayo de este año. El libro se presenta este martes en Barcelona.
Su libro empieza fuerte: “El mayor robo de propiedad intelectual de la historia tuvo lugar a plena luz del día”. ¿El ladrón actuó solo o en compañía de otros?
Fue un robo poco sofisticado y que se consumó prácticamente con un solo clic. Las compañías tecnológicas descargaron ilegalmente las llamadas bibliotecas fantasma, herederas de la cultura abierta y que ponían a disposición de los usuarios todas las nuevas publicaciones y las ya existentes, como si se tratara de una biblioteca pública. Algunas contenían millones de documentos protegidos por las leyes de propiedad intelectual. Las compañías tecnológicas se aprovecharon de esta cultura abierta, la descargaron y la privatizaron, encerrándola en sus centros de datos. Y ahora nos alquilan y ofrecen su contenido a cambio de una cuota.
¿Podríamos decir que es un robo que continúa, de alguna manera, a día de hoy?
Sí. Cuando se publique esta entrevista, los bots de las compañías de inteligencia artificial la digitalizarán y la introducirán en sus servidores. Cuando alguien busque “Oriol Solé” o “Xavier Nueno” en Google o una IA, le aparecerá un resumen y ya no irá a la página de elDiario.es. O sea, también nos robarán esta entrevista.
¿Es un robo que todavía nos cuesta ver más que uno más clásico y tradicional, como un tirón de un bolso por la calle?
Es verdad que los litigios que hay en marcha en EEUU y en Europa aquí están pasando un poco desapercibidos. Los grupos editoriales y los medios europeos tienen abiertos litigios de todo tipo con las empresas tecnológicas. En EEUU, todavía se están instruyendo. Son casos gigantescos, así que creo que tardarán años en resolverse y pasarán por muchas instancias.
¿Sobre qué versan estos juicios?
Los demandantes son periódicos, autores, sociedades de autores y todo el sector editorial. Se dirime si los resultados que ofrecen los modelos de lenguaje de IA cuando haces una búsqueda o introduces un prompt infringen los derechos de autor. Las compañías tecnológicas sostienen que lo que hacen es entrenar unos modelos con estas bibliotecas y que después los modelos producen conocimiento nuevo. Pero, a mi juicio, no está nada claro que sea así. Yo creo que lo que hacen es buscar dentro de la biblioteca y servirte un conocimiento que ya existía.
¿De qué manera se puede refutar esta justificación de las tecnológicas de que producen un nuevo conocimiento?
Hay que obligar a las tecnológicas a abrir sus catálogos. En el momento en que veamos con qué textos se han entrenado, nos daremos cuenta de que, en realidad, las inteligencias artificiales no son tan inteligentes. Son unas máquinas de búsqueda extraordinarias, con una capacidad de indexación del conocimiento realmente impresionante, pero no tienen capacidad para producir conocimiento nuevo.
En realidad, las inteligencias artificiales buscan y modifican un texto ya existente lo suficiente para que lo que nos ofrecen quede por debajo del umbral de infracción de los derechos de autor. Lo transforman lo justo para que nos parezca un conocimiento nuevo y, sobre todo, para que no tengan que pagar derechos por ese conocimiento.
Hemos sustituido un criterio personal, cultural e intelectual por las simples métricas de impacto que tienen los artículos
Su libro, además, explica que no hemos llegado por casualidad hasta aquí, sino que el avance tecnológico profundiza la pérdida del juicio del conocimiento que ya había empezado mucho antes de la IA.
Es un reto escribir una historia de este tipo porque implica cambiar el foco. Normalmente, los libros de tecnología siempre nos hablan de los tecnoligarcas y nunca nos cuentan nada de las personas que trabajaron antes de estos modelos. El libro está planteado como una historia del trabajo, de una serie de profesiones dedicadas a organizar y clasificar el conocimiento. A mediados del siglo XIX, esta tarea empieza a generar un pequeño beneficio. A partir de ese momento, se van construyendo unas industrias de una voracidad enorme, que intentan capturar el beneficio y automatizar el trabajo de las personas que lo producen.
¿Dónde comenzó este proceso?
Empezó en el mundo de la jurisprudencia de los tribunales estadounidenses alrededor de 1850, y después abarca casi todos los campos del conocimiento científico. Constituye la matriz de la privatización de la biblioteca que estamos viviendo hoy, con proyectos primero como Google Books y los modelos de IA actuales. Es una historia de sucesivas privatizaciones, de cómo estas empresas han ido penetrando cada vez más profundamente en la biblioteca y son cada vez más capaces de extraer valor de ella.
En esta historia del trabajo, una constante que también destaca el libro es la invisibilización del trabajo femenino.
Suele haber unos pocos hombres que desarrollan proyectos de organización del trabajo y, después, muchas manos de mujeres que se dedican a organizar y clasificar el conocimiento. A finales del siglo XIX, para abaratar el coste de gestionar la información, se feminizó masivamente el trabajo de las bibliotecas. Se hizo siguiendo un esquema que también se repite hoy: llamar labor mecánica al trabajo de cuidar la memoria del mundo. Hoy son miles de manos invisibles en países pobres las que ajustan el algoritmo y producen este efecto de automatización.
Hay una frase en su libro que creo que resume muy bien el momento actual: “Se publica más que nunca, pero no se sabe qué es importante”.
No lo digo para afirmar que en el pasado se supiera mejor, pero creo que hoy existe una gran confusión en torno a los criterios de relevancia. Hemos sustituido un criterio personal, cultural e intelectual por las simples métricas de impacto que tienen los artículos: cuántas veces se han compartido y toda esta clase de dinámicas. Esto tiene unas consecuencias que todos conocemos. Los periódicos habláis a menudo de estos efectos y también los sufrís.
Y no solo en un plano cultural o intelectual: cada vez hay más gente que pide a la IA que le escriba un correo del trabajo o le haga una lista de viajes de vacaciones.
Me pregunto si cuando delegamos las tareas más cotidianas también perdemos la capacidad de hacerlas. Todos hemos tenido la sensación de que, si no encontrábamos una palabra, la IA nos la podía alquilar. ¡Si hasta si quieres escribir una carta de amor, la IA te da el esquema para hacerlo! Me preocupa estar alquilando aquello que es más común, más intrínsecamente nuestro: el lenguaje, la capacidad de expresarnos, de juzgar y de crear nuestro propio mundo a través de algo que no es solo nuestro, sino que es lo que nos hace humanos. Sacrificamos todo esto para no hacer el esfuerzo de acceder al conocimiento por nosotros mismos, con nuestras propias facultades.
Lo interesante del libro es que su propuesta no consiste en volver a las cavernas, sino que estos distintos modelos de IA sean públicos. ¿Por dónde empezamos?
Lo primero tiene que ver con la transparencia y la posibilidad, ahora casi inexistente, de auditar estos modelos de lenguaje. Los poderes públicos tienen que exigir que se publiquen los catálogos de las bibliotecas con los que se han entrenado las IA.
Hacer públicos los catálogos fue una idea central en la formación de las bibliotecas públicas del siglo XIX. Lo que ofrecía la biblioteca pública era la posibilidad de que cualquier persona accediera a ella y pudiera consultar cuáles eran sus fondos. Los catálogos estaban disponibles para todo el mundo y cualquiera podía interactuar directamente con ellos.
Hoy tenemos que exigir esta transparencia a las compañías tecnológicas porque es algo básico en los Estados democráticos: tienen que explicar de dónde procede toda la información que utilizan, qué parte de esa información está protegida por derechos de autor y cuál pertenece al dominio público.
¿Qué le parecen los proyectos para crear una IA pública?
Son proyectos que se están desarrollando en distintos países y creo que tienen bastante recorrido y son muy importantes. Pero no funcionarán mientras no exista una regulación de las compañías tecnológicas. Es imposible competir con empresas que no tienen ninguna transparencia. Esta es la otra pata: tenemos que definir qué es el dominio público, porque no es lo mismo la cultura abierta que la cultura pública.
¿Cuál es la diferencia entre ambas?
La cultura abierta procede de la contracultura californiana. Es un tipo de cultura que se aleja de la pública, porque es muy antiestatal y busca desproteger y desregular. Es bastante parecida a una forma de anarcocapitalismo. Lo público no es lo mismo que lo abierto. Lo público siempre ha estado regulado: existen unos códigos legales que establecen cómo se puede acceder a todo este conocimiento.
Dentro de esta cultura pública, lo que deberíamos garantizar es que no pueda haber compañías que extraigan todo este material, lo encierren en sus propias bibliotecas y en sus propios centros de datos y después nos lo vuelvan a vender o alquilar. Es una medida esencial y, al mismo tiempo, bastante asequible.
Los proyectos de IA pública no funcionarán mientras no exista una regulación de las compañías tecnológicas
¿Si las tecnológicas publicaran sus bibliotecas, se les terminaría el negocio?
Las compañías tecnológicas se resisten mucho a mostrar esta información. Que yo sepa, ninguna de las grandes empresas tecnológicas lo está haciendo, porque además están inmersas en litigios. Hay modelos un poco abiertos que muestran todos sus parámetros, que son millones, una vez ya se han entrenado con sus bibliotecas, pero no te dan acceso a ellas.
Si algún día tenemos acceso a toda su biblioteca, veremos que la operación ideológica fundamental que lleva a cabo la IA es borrar las fuentes y presentarnos como si fuera suyo algo que en realidad procede de distintas fuentes.
A partir del momento en que sus fuentes sean públicas y transparentes, como las de una biblioteca, las IA ya no nos parecerán tan inteligentes. Empezaremos a ver que, en realidad, son menos un oráculo y más una biblioteca robada. Funcionan más bien como una biblioteca muy sofisticada, de la que podemos aprovecharnos y con la que podemos trabajar, pero debemos garantizar que su acceso sea realmente público.
¿Cómo se puede obligar a unas empresas que operan sin reglas, más allá de los costes legales de los litigios, a estar reguladas?
Detrás de las grandes tecnológicas como OpenAI hay una cultura del saqueo y la rapiña. Lo vemos en este momento con los pánicos a las IA apocalípticas, que están siendo promovidos desde los propios consejos de administración de las empresas para conseguir los grandes contratos del Gobierno estadounidense. Si tienes una tecnología apocalíptica, el Gobierno querrá que haya muy pocas empresas que puedan garantizar el acceso a la información gubernamental.
Este discurso apocalíptico sirve para ocultar las preguntas esenciales: los usuarios estamos pagando muy poco para acceder a estos modelos porque hay capital riesgo detrás que está intentando cerrar la biblioteca pública. Se está poniendo muchísimo dinero en esta especie de carrera para conseguir privatizar toda la biblioteca y toda la información.
¿Qué ocurrirá si tienen éxito y la biblioteca se privatiza del todo?
Una vez que la biblioteca esté privatizada, el capital riesgo se retirará y los costes que todos tendremos que pagar para acceder a este conocimiento subirán. Este es el modelo de las compañías tecnológicas. Cuando Uber apareció, el trayecto costaba mucho menos que un taxi, pero no porque fuera más barato que el de un taxi, sino porque había inversores que estaban poniendo dinero en la empresa con la convicción de que, si conseguían destruir el negocio del taxi, podrían quedarse con todo ese mercado. Y, una vez que se hubieran quedado con él, subirían los precios.
En elDiario.es descubrimos que una empresa compra libros viejos para entrenar a la IA y los destruye.
Las compañías tecnológicas han arrasado con todo lo que podían de las bibliotecas. Cuando estas han empezado a poner límites y se han dado cuenta del enorme coste que supone regalar literalmente su tesoro a las compañías tecnológicas, ha surgido una alternativa: comprar libros de segunda mano. Estos libros literalmente los cortan por el lomo y los escanean a gran velocidad.
Cuando empezó Google Books, todavía había una forma de cuidado del libro. Los libros se escaneaban haciendo fotografías verticales. Estos libros pertenecían a bibliotecas y las bibliotecas no permitían que Google les cortara el lomo. Pero, una vez que estos libros han dejado de contar con esa protección por parte de las bibliotecas, todos los libros de segunda mano que compran los destruyen inmediatamente: les cortan el lomo y los trocean, utilizando un escáner de alta velocidad que no necesita que otra persona vaya pasando las páginas.
En las elecciones de esta semana en EEUU, varios analistas han vinculado la victoria, tras 38 años, de los demócratas en Texas con el malestar ciudadano por los centros de datos. ¿Que la gente note los efectos de esta tecnología en su día a día y sus facturas será decisivo para lograr este cambio?
Es una de las claves. En el modelo de capitalismo actual, los oligopolios tecnológicos ofrecen cero retornos a la sociedad. Todo lo que nos devuelven es ruido y contaminación. Su uso de los recursos públicos del Estado, como las redes eléctricas o el sistema de aguas, es terriblemente abusivo y tiene unas consecuencias que son negativas para el conjunto de la ciudadanía. Estas externalidades las deberían pagar las compañías tecnológicas y no lo hacen.
Debemos avanzar hacia un nuevo y un gran proyecto de biblioteca pública
En Catalunya y en España, se plantea la implantación de centros de datos como sustitución de la industria tradicional. ¿Son una alternativa a una fábrica de coches que cierra?
No son lo mismo. No hay nadie trabajando dentro de un centro de datos. Es una infraestructura que contará con tres o cuatro personas de seguridad y poco más. Me parece muy significativo que estemos destinando una inversión tan descomunal a los centros de datos y, al mismo tiempo, estemos desprotegiendo de una manera tan evidente y flagrante las bibliotecas, que son las que contienen el conocimiento que después se privatiza en esos centros de datos y que las compañías tecnológicas nos vuelven a vender. Debemos avanzar hacia un nuevo y gran proyecto de biblioteca pública.
¿Cómo tendría que ser este proyecto?
La biblioteca pública no fue algo espontáneo. Nació en el siglo XIX, de las confiscaciones de los libros que estaban en los monasterios y de las colecciones que tenían los aristócratas. Durante la Revolución Francesa, el Estado se quedó con sus colecciones y también con las de los monasterios, y en España ocurrió algo parecido con las desamortizaciones de la Iglesia.
Tenemos que entender que el proyecto de la biblioteca pública es un proyecto activo, que hay que defender en un sentido político, y avanzar hacia un horizonte que no siempre será el más cómodo. A las compañías privadas no les interesa que exista algo como la biblioteca pública. Preferirían que no existiera. Pero esta biblioteca pública debe tener unos parámetros diferentes de los que ha tenido hasta ahora.
¿Cuáles?
No solo debe proteger el patrimonio bibliográfico, sino que también tenemos que pensar en todo lo que hacemos con los datos y con la transmisión del conocimiento. Todo lo que forma parte del patrimonio público del conocimiento del Estado —las bibliotecas, los archivos, la publicación científica, la investigación, las universidades...— está financiado con dinero público.
No puede ser que todo este conocimiento se privatice inmediatamente después de publicarse y que nuestro acceso quede totalmente mediado por las grandes compañías, que lo regulan en función de lo que paguemos mediante una suscripción. Debemos proteger los recursos que los estados destinan a la investigación y a la educación, y evitar que puedan privatizarse en cuanto se ponen a disposición de los ciudadanos.
Última pregunta. ¿Ha utilizado más IA o ha visitado más archivos presencialmente para este libro?
Uso mucho la IA para buscar información. Como tecnología de búsqueda me parece muy potente. Pero para el libro tuve que conocer muy bien casos que tienen bastante sustancia, e incluso podríamos decir que son un poco freaks. Para estudiar estos casos, con la IA no basta, tiene un límite y he descubierto que, a partir de cierto punto, ya no sabe qué decir, lo que me ha reafirmado en que la IA no es un conocimiento infinito, sino un conocimiento muy limitado y contenido.
La mayor parte de referencias de este libro proceden de material que no está digitalizado. Para hacer una investigación de este tipo, tienes que trabajar codo con codo con archiveros y archiveras y bibliotecarios y bibliotecarias. Son las personas que saben guiarte por un archivo con cajas y cajas de papeles y probablemente son las únicas que saben orientarse allí dentro. ¡Sin ellos no hubiera sido posible el libro!

0